
LeetCode
每日一题
799. 香槟塔 - 力扣(LeetCode)
香槟塔 点击展开题目

思路:递推
假设f[i][j]有pour的酒,不考虑溢出。
- f[i][j] > 1 表示有溢出 溢出的量× = (f[j][j] - 1) / 2;
- 否则没有溢出 递推计算所有的f[i]], 答案为f[query_row][query_glass]和1取min

class Solution {
public:
    double champagneTower(int poured, int query_row, int query_glass) {
        vector<vector<double>> f(query_row + 1, vector<double>(query_row + 1));
        f[0][0] = poured;
        for(int i = 0; i < query_row; i ++)
        {
            for(int j = 0; j <= i; j ++)
            {
                if(f[i][j] > 1)
                {
                    double x = (f[i][j] - 1) / 2;
                    f[i + 1][j] += x, f[i + 1][j + 1] += x;
                }
            }
        }
        return min(1.0, f[query_row][query_glass]);
    }
};
从根到叶的二进制数之和
点击展开题目

思路 遍历,维护从根节点到当前节点的二进制和 深度优先遍历dfs,当前结点到根的二进制值就是父结点乘以2加上当前结点的值。如果遍历到叶子结点,那么就更新答案 
- 时间复杂度:
- 空间复杂度: C++
  /**
  * Definition for a binary tree node.
  * struct TreeNode {
  *     int val;
  *     TreeNode *left;
  *     TreeNode *right;
  *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
  *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
  *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
  * };
  */
  class Solution {
  public:
      int sumRootToLeaf(TreeNode* root) {
          return dfs(root, 0);
      }

      int dfs(TreeNode* root, int x)
      {
          if(!root) return 0;
          x = x * 2 + root->val;
          if(!root->left && !root->right) return x;
          return dfs(root->left, x) + dfs(root->right, x);
      }
  };
1582.二进制矩阵中的特殊位置
点击展开题目


思路:开两个数组分别记录行和列中有几个1,判断每个位置行和列是否只有当前一个1。
  class Solution {
  public:
      int numSpecial(vector<vector<int>>& mat) {
          int n = mat.size(), m = mat[0].size();
          vector<int> row(n), col(m);
          for(int i = 0; i < n; i ++)
              for(int j = 0; j < m; j ++)
              {
                  row[i] += mat[i][j];
                  col[j] += mat[i][j];
              }

          int res = 0;
          for(int i = 0; i < n; i ++)
              for(int j = 0; j < m; j ++)
                  if(mat[i][j] == 1 && row[i] == 1 && col[j] == 1)
                      res ++;
          return res;
      }
  };
1758. 生成交替二进制字符串的最少操作数
点击展开题目
  class Solution {
  public:
      int minOperations(string s) {
          int cnt = 0;
          for(int i = 0; i < s.size(); i ++)
          {
              if(s[i] != ('0' + i % 2))
              {
                  cnt ++;
              }
          }
          return min(cnt, (int)s.size() - cnt);
      }
  };
1888. 使二进制字符串字符交替的最少反转次数
点击展开题目
思路: 要求操作二最少,操作一无限制,操作一所有可能均为 S+S中字串
111000_____
_110001____
__100011___
___000111__
____001110_
_____011100
要求所有字串交替,可能情况如下
- 0101...对于每个字符串的下标位置i需要满足
int(s[i]) % 2 == i % 2 - 1010...对于每个字符串的下标位置i需要满足
int(s[i]) % 2 != i % 2
把满足 int(t[i])=imod2 的 t[i] 视作 . 字符,把满足 int(t[i]) !=i mod 2 的 t[i] 视作 X 字符,我们可以得到X.XX.XX.XX.
- 当子串左端点下标是偶数时:
- 子串中的 X 的个数就是改成 0101⋯ 的类型 2 操作次数。
- 子串中的 . 的个数就是改成 1010⋯ 的类型 2 操作次数。
- 当子串左端点下标是奇数时:
- 子串中的 . 的个数就是改成 0101⋯ 的类型 2 操作次数。
- 子串中的 X 的个数就是改成 1010⋯ 的类型 2 操作次数。
我们可以统计子串中的 X 的个数 cnt,那么 n−cnt 就是子串中的 . 的个数。
对于每个子串,既可以改成 0101⋯,又可以改成 1010⋯,取最小值,用 min(cnt,n−cnt) 更新答案的最小值。
题解参考:灵茶山艾府
class Solution {
public:
    int minFlips(string s) {
        int n = s.size(), ans = n, cnt =  0;
        for(int i = 0; i < n * 2 - 1; i ++)
        {
            if(s[i % n] % 2 != i % 2)
                cnt ++;
            int left = i - n + 1;// 算窗口左边界
            if(left < 0)// 窗口不够长,不算
                continue;
            ans = min({ans, cnt, n - cnt});// 算当前窗口最小修改次数
            if(s[left] % 2 != left % 2)// 删掉滑出窗口的左字符
                cnt --;
        }
        return ans;
    }
};
数组折叠求和
点击展开题目 数组折叠求和
思路 通过观察可知每次折叠操作后数组长度减半(向上取整),直到数组只剩一个元素。每次折叠后的新数组元素之和与初始数组元素之和相等。因此,只需计算从初始数组到只剩一个元素的折叠次数,再乘以初始数组元素之和,即可得到每一步新数组元素之和的总和。
#include <bits/stdc++.h>
using namespace std;
typedef long long LL;
const int N = 1e5 + 10;
LL a[N], sum;
int n, len, step;

int main()
{
    scanf("%d", &n);
    for(int i = 0; i < n; i ++)
    {
        scanf("%lld", &a[i]);
        sum += a[i];
    }
    len = n;
    while(len > 1)
    {
        len = len + 1 >> 1;
        step ++;
    }
    printf("%lld\n", step * sum);
    return 0;
}[待补充][待补充]统计目标字符
点击展开题目 统计目标字符
思路 先遍历目标字符集字符串,将目标字符在布尔数组 isTarget 中对应的位置标记为 true。然后遍历矩阵的每一个字符,若该字符在 isTarget 中对应位置为 true,则计数加一。最后输出计数结果,即为矩阵中属于目标字符集的字符总数。
#include <bits/stdc++.h>
using namespace std;
const int N = 1010;
string grid[N];
int n;
bool isTarget[26] = {false};

int main()
{
    string target;
    cin >> target;
    for(int i = 0; i < target.size(); i ++)
    {
        isTarget[target[i] - 'A'] = true;
    }

    cin >> n;
    int total = 0;
    for(int i = 0; i < n; i ++)
    {
        cin >> grid[i];
        for(int j = 0; j < grid[i].size(); j ++)
        {
            total += isTarget[grid[i][j] - 'A'];
        }
    }
    cout << total << "\n";
    return 0;
}[待补充][待补充]第一个正元素
点击展开题目 第一个正元素
思路 利用数组中负元素在前、正元素在后的有序性质,采用二分查找法。通过比较中间元素的正负,动态调整左右指针,逐步缩小查找区间,最终找到第一个正元素的下标。若遍历完整个区间都未找到正元素,则输出 。该方法时间复杂度为 ,符合题目要求。
#include <bits/stdc++.h>
using namespace std;
const int N = 1e5 + 10;
int a[N], n;
int main()
{
    cin >> n;
    for(int i = 0; i < n; i ++) cin >> a[i];
    int l = 0, r = n;
    while(l < r)
    {
        int mid = l + r >> 1;
        if(a[mid] < 0) l = mid + 1;
        else r = mid;
    }
    cout << (l < n? l : -1) << "\n";
    return 0;
}import java.util.Scanner;
public class FirstPositiveElement {
public static void main(String[] args) {
Scanner scanner = new Scanner(System.in);
int n = scanner.nextInt();
int[] a = new int[n];
for (int i = 0; i < n; i++) {
scanner.nextInt();
}
int l = 0, r = n;
while (l < r) {
int mid = l + r >> 1;
if (a[mid] < 0) {
l = mid + 1;
} else {
r = mid;
}
}
System.out.println(l < n? l : -1);
}
}n = int(input())
a = list(map(int, input().split()))
l, r = 0, n
while l < r:
mid = l + r >> 1
if a[mid] < 0:
l = mid + 1
else:
r = mid
print(l if l < n else -1)交替最大最小元素
点击展开题目 交替最大最小元素
思路 先对给定的整数序列进行排序,然后使用双指针法。一个指针从排序后数组的末尾(指向最大元素),另一个指针从数组开头(指向最小元素)。每次交替从两端取元素放入新数组,直至所有元素都被处理。这样就得到了按照先最大、再最小交替选取规则组成的新序列。
#include <bits/stdc++.h>
using namespace std;
const int N = 1e5 + 10;
int a[N], b[N];
int n;

int main()
{
    cin >> n;
    for(int i = 0; i < n; i ++) cin >> a[i];
    sort(a, a + n);
    int l = 0, r = n - 1, idx = 0;
    while(l <= r)
    {
        b[idx ++] = a[r --];
        if(l <= r)
        {
            b[idx ++] = a[l ++];
        }
    }
    for(int i = 0; i < n; i ++)
        cout << b[i] << " \n"[i == n - 1];

    return 0;
}import java.util.Arrays;
import java.util.Scanner;
public class AlternateMaxMin {
public static void main(String[] args) {
Scanner scanner = new Scanner(System.in);
int n = scanner.nextInt();
int[] a = new int[n];
for (int i = 0; i < n; i++) {
a[i] = scanner.nextInt();
}
Arrays.sort(a);
int[] b = new int[n];
int l = 0, r = n - 1, idx = 0;
while (l <= r) {
b[idx++] = a[r--];
if (l <= r) {
b[idx++] = a[l++];
}
}
for (int i = 0; i < n; i++) {
if (i == n - 1) {
System.out.print(b[i]);
} else {
System.out.print(b[i] + " ");
}
}
}
}n = int(input())
a = list(map(int, input().split()))
a.sort()
b = []
l, r = 0, n - 1
while l <= r:
b.append(a[r])
r -= 1
if l <= r:
b.append(a[l])
l += 1
print(' '.join(str(x) for x in b))最大分割奇偶乘积
点击展开题目 最大分割奇偶乘积
思路 通过前缀和数组 oddPrefix 记录前 个元素中奇数位置元素的和。然后从后往前遍历数组,计算后半部分偶数位置元素的和 evenSum,在遍历过程中,每次计算 oddPrefix[i] * evenSum 并更新最大值,最终得到最大乘积。
#include <bits/stdc++.h>
using namespace std;
typedef long long LL;
const int N = 1e5 + 10;
LL a[N], oddPrefix[N];
int n;
LL maxProduct, evenSum;

int main()
{
    scanf("%d", &n);
    for(int i = 1; i <= n; i ++)
    {
        scanf("%lld", &a[i]);
        oddPrefix[i] = oddPrefix[i - 1] + (i % 2? a[i] : 0);
    }
    for(int i = n; i >= 1; i --)
    {
        if(i % 2 == 0)
            evenSum += a[i];
        maxProduct = max(maxProduct, oddPrefix[i] * evenSum);

    }
    printf("%lld\n", maxProduct);
    return 0;
}import java.util.Scanner;
public class MaxSplitOddEvenProduct {
public static void main(String[] args) {
Scanner scanner = new Scanner(System.in);
int n = scanner.nextInt();
long[] a = new long[n + 1];
long[] oddPrefix = new long[n + 1];
for (int i = 1; i <= n; i++) {
a[i] = scanner.nextLong();
oddPrefix[i] = oddPrefix[i - 1] + (i % 2 == 1? a[i] : 0);
}
long maxProduct = 0;
long evenSum = 0;
for (int i = n; i >= 1; i--) {
if (i % 2 == 0) {
evenSum += a[i];
}
maxProduct = Math.max(maxProduct, oddPrefix[i] * evenSum);
}
System.out.println(maxProduct);
}
}n = int(input())
a = list(map(int, input().split()))
odd_prefix = [0]
for i in range(n):
if (i + 1) % 2:
odd_prefix.append(odd_prefix[-1] + a[i])
else:
odd_prefix.append(odd_prefix[-1])
max_product = 0
even_sum = 0
for i in range(n - 1, -1, -1):
if (i + 1) % 2 == 0:
even_sum += a[i]
max_product = max(max_product, odd_prefix[i + 1] * even_sum)
print(max_product)动态规划
完全平方数
完全平方数
class Solution {
public:
    bool check(int n)
    {
        int r = sqrt(n);
        return r * r == n;
    }

    int numSquares(int n) {
        if(check(n)) return 1;

        for(int a = 1; a <= n / a; a ++)
            if(check(n - a * a))
                return 2;

        while(n % 4 == 0) n /= 4;
        if(n % 8 != 7) return 3;

        return 4;
    }
};class Solution {
public:
int numSquares(int n) {
vector<int> f(n + 1, n);
f[0] = 0;
for(int i = 1; i <= n; i ++)
{
for(int j = 1; j <= i / j; j ++)
{
f[i] = min(f[i], f[i - j * j] + 1);
}
}
return f[n];
}
};零钱兑换
class Solution {
public:
    int coinChange(vector<int>& coins, int amount) {
        int INF = INT_MAX;
        vector<int> f(amount + 1, INF);
        f[0] = 0;

        for(int i = 1; i <= amount; i ++)
            for(int j = 0; j < coins.size(); j ++)
                if(coins[j] <= i && f[i - coins[j]] != INF)
                    f[i] = min(f[i], f[i - coins[j]] + 1);

        return f[amount] == INF ? -1 : f[amount];
    }
};
周赛490
计算比赛分数差
点击展开题目
思路:模拟,定义两个变量first、second表示第一个人和第二个人的得分,定义一个bool型flag表示是否第一个为主动玩家。如果 nums[i] 是奇数或者每第 6 场比赛,交换角色则flag =! flag,最后返回first-second
class Solution {
public:
    int scoreDifference(vector<int>& nums) {
        int first = 0, second = 0;
        bool flag = true;
        for(int i = 0; i < nums.size(); i ++)
        {
            if(nums[i] % 2) flag = !flag;
            if((i + 1) % 6 == 0) flag = !flag;
            if(flag) first += nums[i];
            else second += nums[i];
        }
        return first - second;
    }
};
阶数数字排列
点击展开题目
class Solution {
public:
    int fact(int n)//计算阶乘
    {
        if(n <= 1) return 1;
        return n * fact(n - 1);
    }
    bool isDigitorialPermutation(int n) {
        //1.预处理0-9的阶乘
        int f[10] = {0};
        for(int i = 0; i < 10; i ++)
        {
            f[i] = fact(i);
        }
        //2.计算n各位阶乘之和记为sum,计算每n中个数字出现的次数
        int cnt[10] = {};
        int t = n;
        int sum = 0;
        while(t)
        {
            cnt[t % 10] ++;
            sum += f[t % 10];
            t /= 10;
        }
        //3 计算sum中每个数字出现频率
        t = sum;
        while(t)
        {
            cnt[t % 10] --;
            t /= 10;
        }
        //4.判断sum中每个数字出现频率和n是否相同,相同则存在
        for(int i = 0; i < 10; i ++)
            if(cnt[i] != 0)
                return false;
        return true;
    }
};
重新排列后的最大按位异或值
点击展开题目
class Solution {
public:
    string maximumXor(string s, string t) {
        int c0 = 0, c1 = 0;
        int n = s.size();
        string res;
        for(int i = 0; i < t.size(); i ++)
        {
            if(t[i] == '0') c0 ++;
            else c1 ++;
        }

        for(int i = 0; i < n; i ++)
        {
            if(s[i] == '1')
            {
                if(c0 > 0)
                {
                    res += '1';
                    c0 --;
                }
                else
                {
                    res += '0';
                    c1 --;
                }
            }
            else
            {
                if(c1 > 0)
                {
                    res += '1';
                    c1 --;
                }
                else
                {
                    res += '0';
                    c0 --;
                }
            }
        }
        return res;
    }
};
LeetCode Hot 100
240. 搜索二维矩阵 II - 力扣(LeetCode)
搜索二维矩阵 II 点击展开题目


思路1:观察到m、n均小于等于300,可以直接双重循环进行枚举。 时间复杂度 空间复杂度
class Solution {
public:
    bool searchMatrix(vector<vector<int>>& matrix, int target) {
        for(int i = 0; i < matrix.size(); i ++)
        {
            for(int j = 0; j < matrix[0].size(); j ++)
            {
                if(matrix[i][j] == target)
                {
                    return true;
                }
            }
        }
        return false;
    }
};
思路2:对每一行进行二分查找 时间复杂度 空间复杂度
class Solution {
public:
    bool searchMatrix(vector<vector<int>>& matrix, int target) {
        int n = matrix.size();
        int m = matrix[0].size();
        //枚举每行
        for(int i = 0; i < n; i ++)
        {
            //对每一行进行二分查找
            int l = 0, r = m - 1;
            while(l <= r)
            {
                int mid = (r - l) / 2 + l;//直接(l+r)/2可能会溢出
                if(matrix[i][mid] > target) r = mid - 1;
                else if(matrix[i][mid] < target) l = l + 1;
                else return true;
            }
        }
        return false;
    }
};
思路3:从右上角进行查找,设当前的数为t,共有三种可能
- t==target返回true即可
- t>target代表t所在列元素都比target大,答案一定不在当前列,可以删除当前列
- t<taeget代表t所在行元素都比target小,答案一定不在当前行,可以删除当前行
时间复杂度
空间复杂度

class Solution {
public:
    bool searchMatrix(vector<vector<int>>& matrix, int target) {
        if(matrix.empty() || matrix[0].empty()) return false;
        int n = matrix.size();
        int m = matrix[0].size();
        int i = 0, j = m - 1;
        while(i < n && j >= 0)
        {
            int t = matrix[i][j];
            if(t == target) return true;
            else if(t > target) j --;
            else i ++;
        }
        return  false;
    }
};
二叉树
98. 验证二叉搜索树
点击展开题目


思路:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    bool isValidBST(TreeNode* root) {
        return dfs(root, LONG_MIN, LONG_MAX);
    }

    bool dfs(TreeNode* root, long long lower, long long upper)
    {
        if(root == nullptr) return true;

        if(root->val <= lower || root->val >= upper) return false;

        return dfs(root->left, lower, root->val) && dfs(root->right, root->val, upper);
    }
};
437. 路径总和 III
路径总和 III
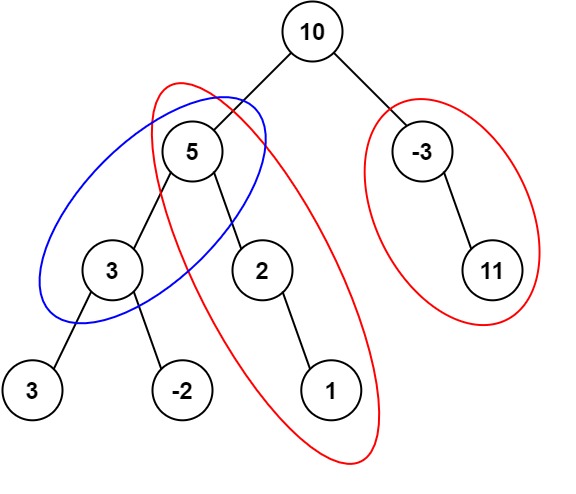
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    unordered_map<long long, long long> cnt;//记录前缀和出现的次数
    int res = 0; //记录targetsum出现数量

    int pathSum(TreeNode* root, int targetSum) {
        cnt[0] = 1;//初始化,当cur - traget = 0 表示当前路径就符合,因此答案+1
        dfs(root, targetSum, 0);
        return res;
    }

    void dfs(TreeNode* root, long long targetSum, long long cur)
    {
        if(!root) return;
        cur += root->val;//前缀和
        res += cnt[cur - targetSum];//更新target出现次数
        cnt[cur] ++;//更新前缀和出现次数
        dfs(root->left, targetSum, cur), dfs(root->right, targetSum, cur);//递归处理左子树和有子树
        cnt[cur] --;//回溯
    }
};